为什么单机多卡训练,不会因为多一张 GPU 就快一倍?
为什么单机多卡训练,不会因为多一张 GPU 就快一倍?
ytkz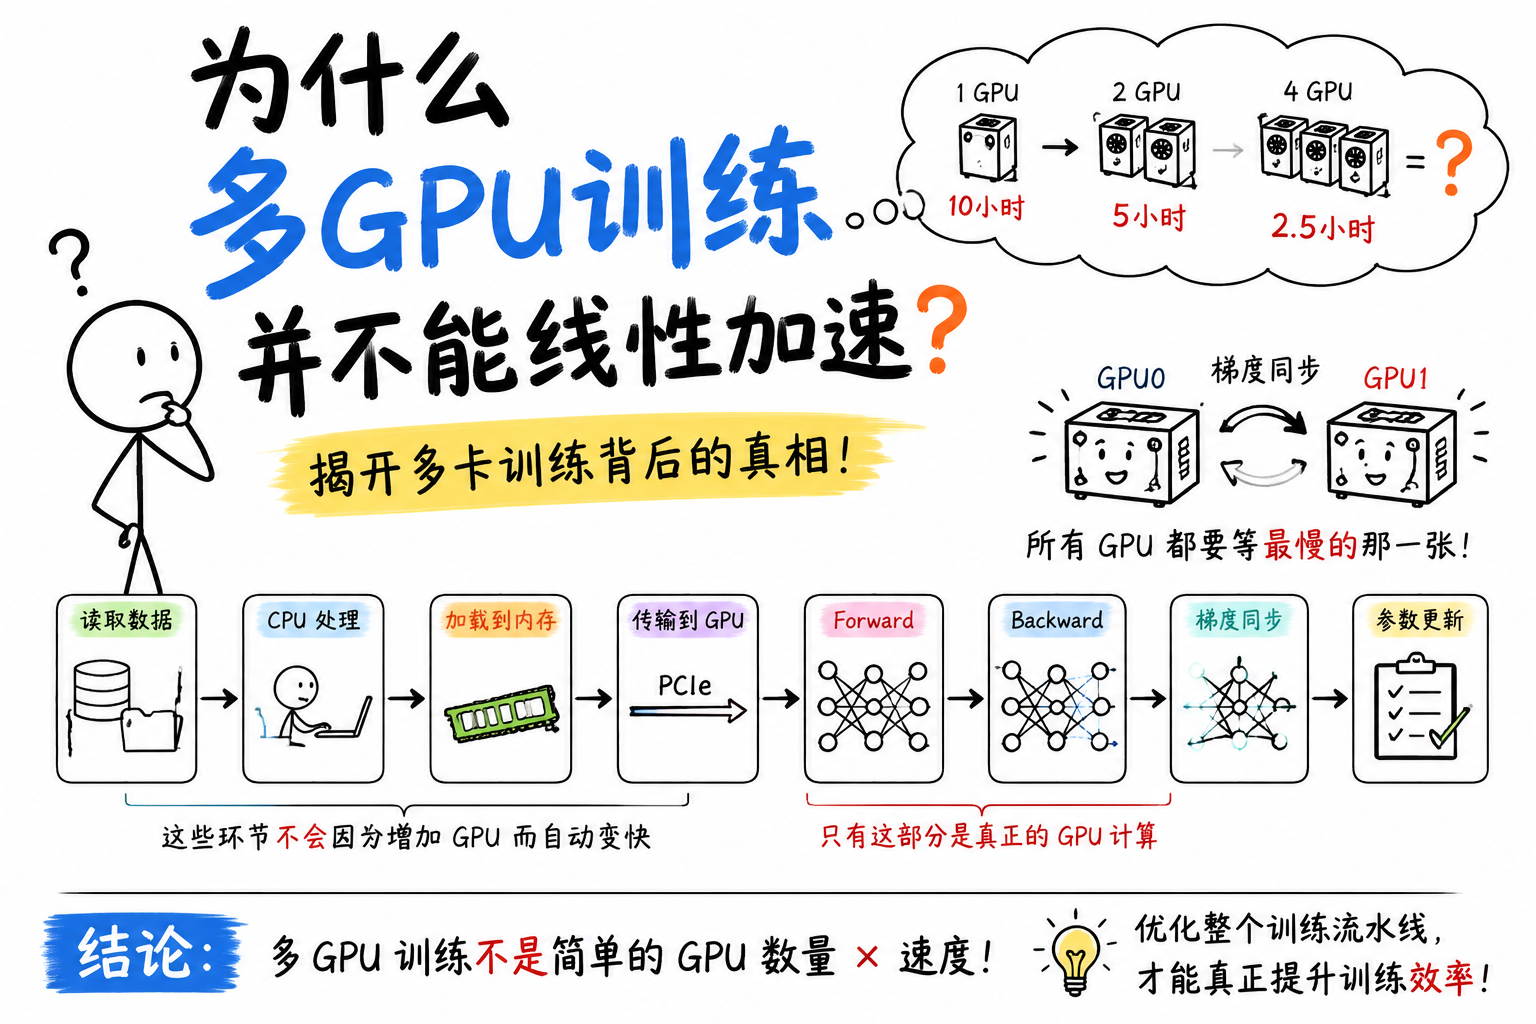
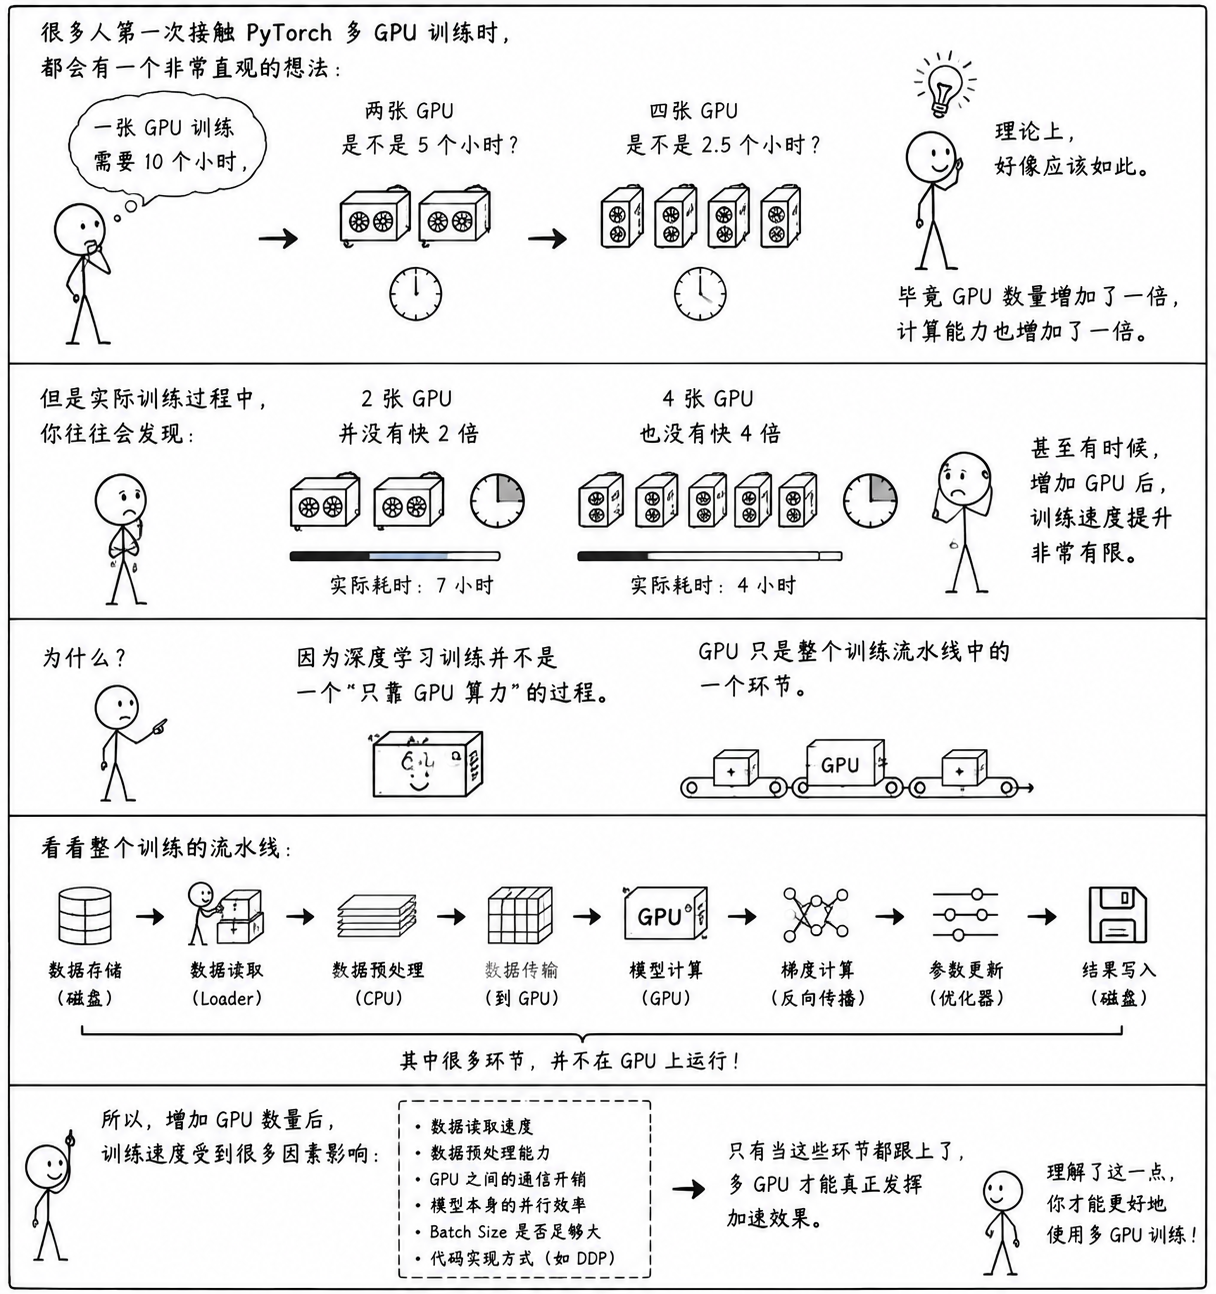
很多人第一次接触 PyTorch 多 GPU 训练时,都会有一个非常直观的想法:
一张 GPU 训练需要 10 个小时,两张 GPU 是不是 5 个小时?四张 GPU 是不是 2.5 个小时?
理论上,好像应该如此。
毕竟 GPU 数量增加了一倍,计算能力也增加了一倍。
但是实际训练过程中,你往往会发现:
2 张 GPU 并没有快 2 倍,4 张 GPU 也没有快 4 倍。
甚至有时候,增加 GPU 后,训练速度提升非常有限。
为什么?
因为深度学习训练并不是一个“只靠 GPU 算力”的过程。
GPU 只是整个训练流水线中的一个环节。
训练模型,不只是 GPU 在工作
很多人理解训练过程时,会简单认为:
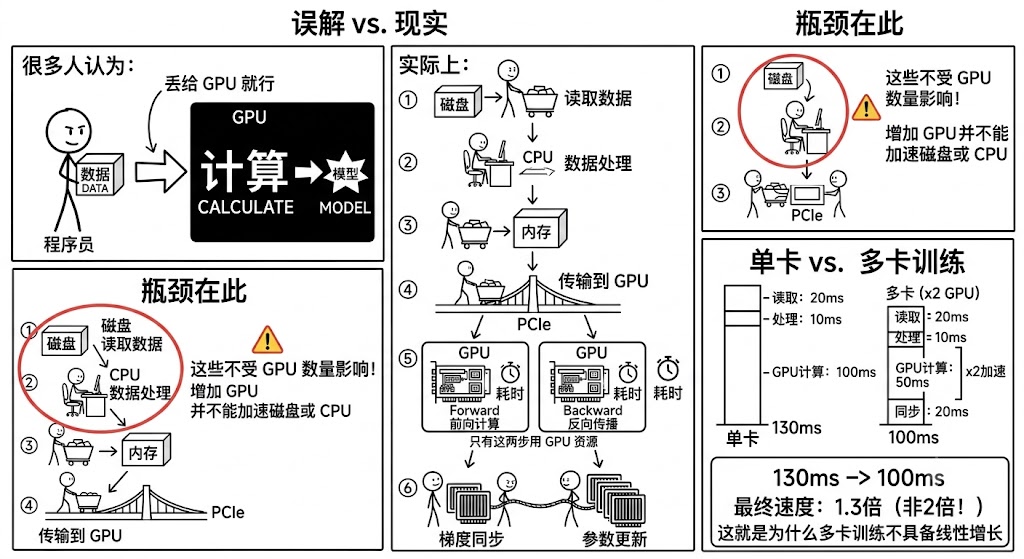
把数据丢给 GPU,然后 GPU 负责计算。
实际上,一次完整的训练迭代,背后包含很多步骤:
读取数据
    ↓
CPU 数据处理
    ↓
数据加载到内存
    ↓
传输到 GPU
    ↓
Forward 前向计算
    ↓
Backward 反向传播
    ↓
梯度同步
    ↓
参数更新
其中只有:
- Forward
- Backward
是真正消耗 GPU 计算资源的部分。
但是:
- 数据读取依赖磁盘
- 数据增强依赖 CPU
- 数据传输依赖 PCIe
- 多卡同步依赖 GPU 通信链路
这些环节并不会因为你增加 GPU 数量而自动变快。
举一个简单例子:
假设一次训练:
数据读取:20ms
数据处理:10ms
GPU计算:100ms
梯度同步:20ms
单卡情况下:
总时间:20 + 10 + 100=130ms增加 GPU 后:
GPU计算变成:
100ms → 50ms但是其它部分仍然存在:
20 + 10 + 50 + 20=100ms最终速度:
130 / 100 = 1.3倍而不是2倍。
这就是为什么多卡训练不会线性增长。
PyTorch DDP:多张 GPU 到底做了什么?
目前 PyTorch 最常用的多 GPU 训练方式是:
DistributedDataParallel(DDP)
它的核心思想其实很简单:
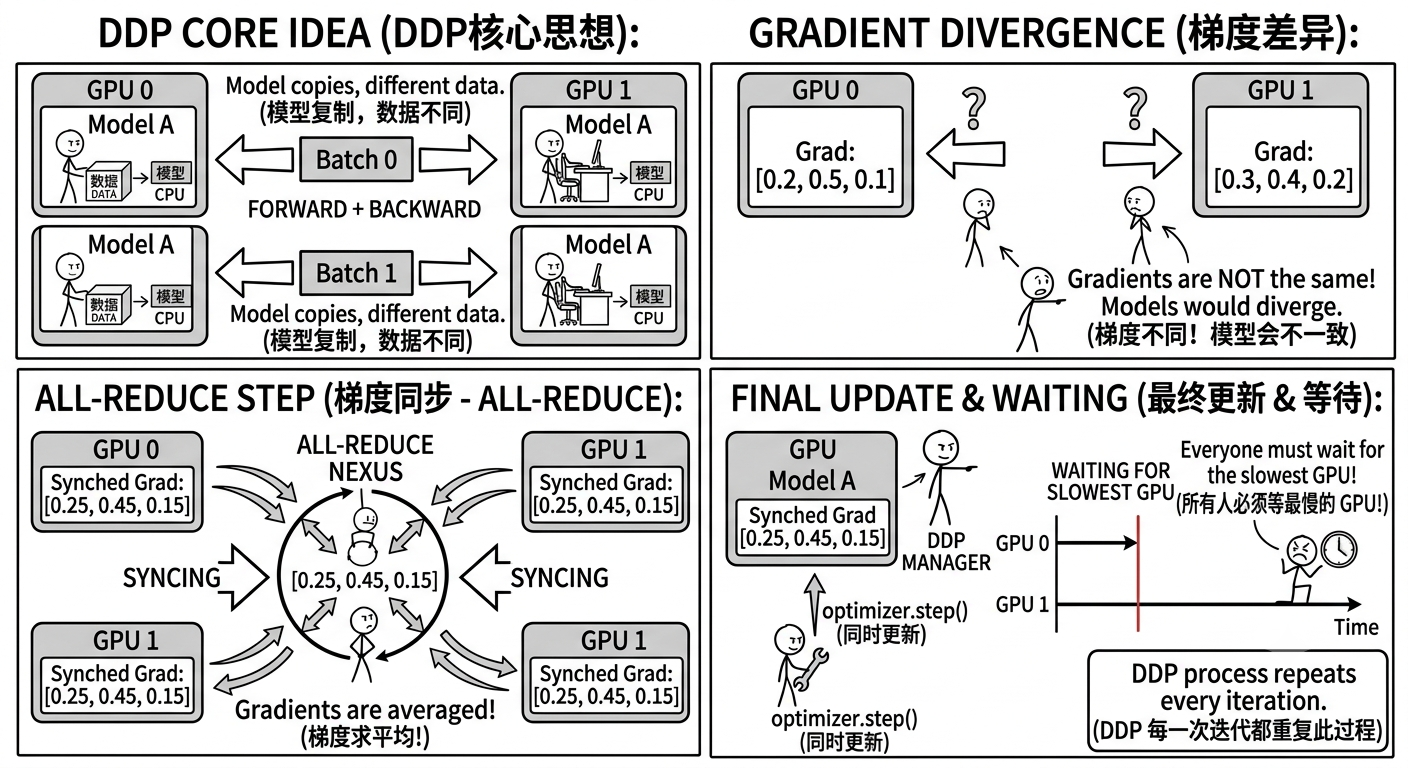
每张 GPU 都复制一份完整模型,然后分别计算不同的数据。
比如两张 GPU:
GPU0

模型A

Batch 0


GPU1

模型A

Batch 1
训练开始后:
两个 GPU 同时进行:
Forward

↓

Backward
这样计算量被分摊了。
看起来非常美好。
但是问题来了:
两个 GPU 计算出来的梯度是不一样的。
例如,GPU0:
梯度:[0.2,0.5,0.1]GPU1:
梯度:[0.3,0.4,0.2]如果直接更新模型:GPU0 的参数会变成一套。GPU1 的参数会变成另一套。
模型马上就不一致了。
所以 DDP 在每一次反向传播之后,都需要做一件事情:梯度同步。
也就是:
GPU0 梯度
       \
        AllReduce
       /
GPU1 梯度
所有 GPU 交换梯度,然后求平均。
同步完成后:所有 GPU 才能执行:
optimizer.step()更新模型参数。
所以多卡训练有一个特点:所有 GPU 必须等最慢的那一张。
只要有一张 GPU 还没有完成计算,其他 GPU 都要等待。
GPU 越多,通信压力越大
很多人觉得:
GPU 越多,计算能力越强,速度应该越快。
这个说法只对了一半。
GPU 数量增加以后:计算确实变快了。
但是通信也增加了。
假设你的模型参数有:
2GB每一次训练,都需要同步对应的梯度。
单卡:
不需要同步两卡:
需要一次梯度通信四卡:
更多 GPU 之间通信八卡:
通信规模进一步增加最终训练时间变成:
训练时间 =计算时间+通信时间而不是:
训练时间 = 计算时间当 GPU 数量越来越多时:计算部分越来越短。
但是通信部分占比越来越高。
这就是大规模训练中的经典问题:
通信瓶颈。
实际多卡能提升多少?
实际工程中:
如果:
- 数据加载正常
- Batch 足够大
- GPU 通信良好
- 模型计算占比较高
通常情况:
| GPU数量 | 理论加速 | 实际常见 |
|---|---|---|
| 1张 | 1倍 | 1倍 |
| 2张 | 2倍 | 约1.7~1.9倍 |
| 4张 | 4倍 | 约3~3.7倍 |
| 8张 | 8倍 | 约6~7倍 |
当然,不同模型差异非常大。
例如:
一个小型 CNN:
可能多卡收益很低。
一个大型 Transformer:
可能多卡收益非常明显。
如何提高多 GPU 训练效率?
真正高效的多卡训练,不是简单增加 GPU。
而是优化整个系统。
常见优化方向:
1. 提高 GPU 利用率
检查:
nvidia-smi观察 GPU 是否长期满载。
2. 优化数据加载
调整:
num_workers

pin_memory=True

persistent_workers=True
3. 使用混合精度训练
例如:
torch.cuda.amp减少显存占用,提高计算速度。
4. 增大 Batch Size
让每张 GPU 都有足够计算任务。
总结
单机多卡训练,并不是简单的:
GPU 数量 × 速度。
真正的训练速度取决于整个系统:
训练速度 = GPU计算效率 + 数据加载效率 + GPU通信效率 + 存储效率 + 软件优化
增加 GPU,只是提高了其中一个环节。
如果其它环节没有跟上,多出来的 GPU 反而可能处于等待状态。